【R】StanでMAKE AMERICA GREAT AGAINの変化点検知

2020年はアメリカで大統領選挙が行われる年ですが, 前回の選挙戦でのトランプ氏は「MAKE AMERICA GREAT AGAIN」というスローガンで注目を集めていましたね。 今回の記事では、トランプ氏の「MAKE AMERICA GREAT AGAIN」ツイート投稿数の推移を調べてみました。
トランプ大統領の「MAKE AMERICA GREAT AGAIN」ツイート数の可視化
- データ
トランプ氏のツイッターの2015年3月 ~ 2020年2月までの5年間の投稿ツイートのうち, 「MAKE AMERICA GREAT AGAIN」を含む436ツイートを取得した.
「MAKE AMERICA GREAT AGAIN」の可視化
require(tidyverse)
trump_tweets <- read_csv('./trump_tweets.csv')

# 月ごとにツイートを集計
trump_tweets.count <- trump_tweets %>%
  count(date_to_month = as.POSIXct(投稿日, format="%Y-%m-%d") %>% round(units = 'month') %>% as.POSIXct())

# 多い順
trump_tweets.count %>% arrange(-n)
# 可視化
ggplot(trump_tweets.count, aes(x=date_to_month, y=n)) +
  geom_col() +
  xlab('year_to_month') + ylab('tweets per month') +
  ggtitle('# "MAKE AMERICA GREAT AGAIN" per month in tweets of @realDonaldTrump')
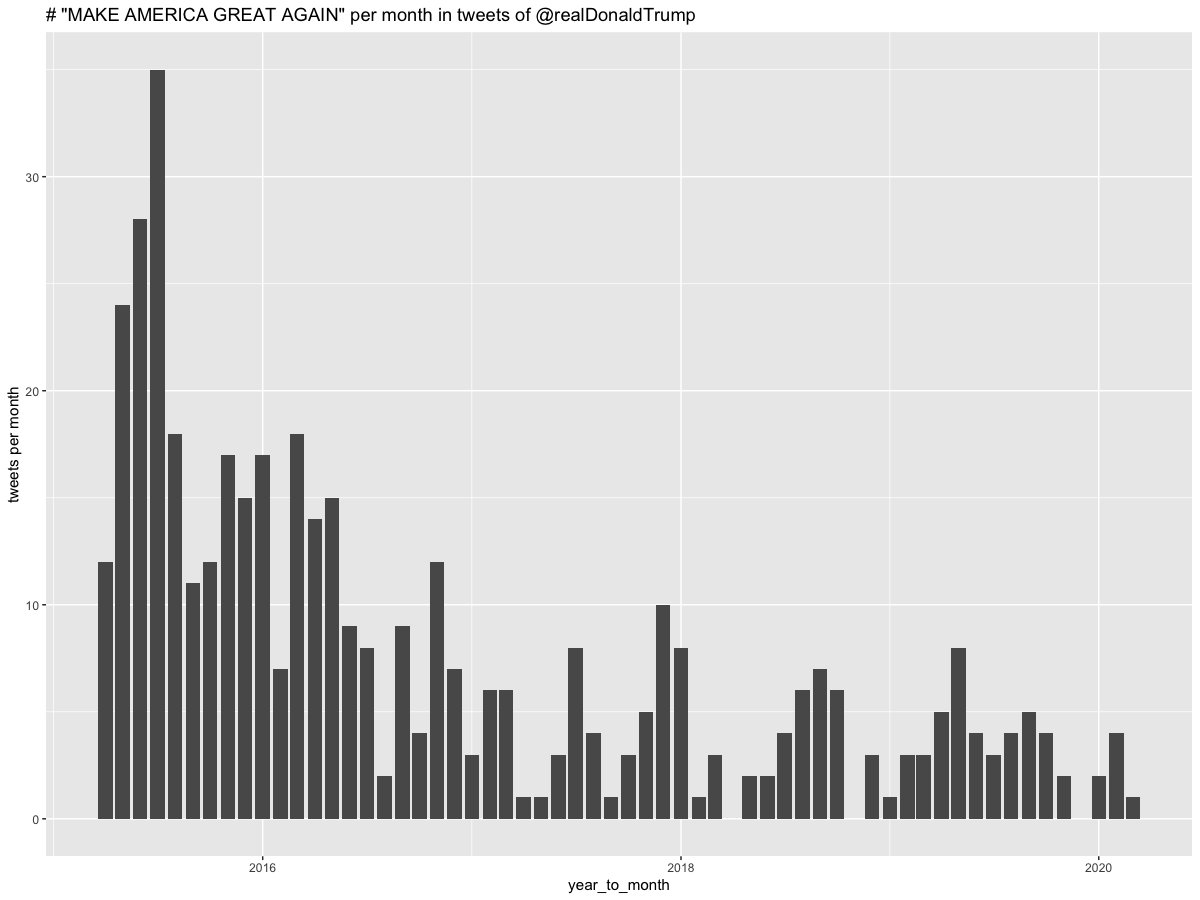
グラフをみてみると, 2015年~2016年にかけツイート数のピークがみられます.
トランプの大統領選出馬立候補日が2015/6/16なので,
選挙活動開始タイミング〜大統領当選までの期間とおおよそ重なります.
変化点検出
ツイート数について2016年付近と比較して2020年付近ではツイート数が減少しているように見受けられます. 以下ツイート数変化の境がいつになるのか、変化点検知を試します.
モデル
を変化点, その前後で
期における投稿数
がパラメータがそれぞれ
のPoisson分布で与えられるモデルを立てる。
には次のような事前分布を課します
このモデルの同時分布は次のようになります,
Stanでのサンプリング
Stan Users Guideを参考に、 Stanを用いたパラメータ推定を行います。
Poisson分布のパラメータのサンプリング
ハイパーパラメータに離散確率変数を含むモデルでは, Stanを用いて直接サンプリングは行えないため, 離散確率変数に関して周辺化を行う必要がある.
に関する周辺化を行った上で
からサンプリングを行う.
からサンプリングを行うため,
を計算する.
stanコードで実装したものが次になります.
data {
  int<lower=0> T_max;
  int<lower=0> tweets[T_max];
  real<lower=0> a;
  real<lower=0> b;
}

transformed data {
  real log_unif;
  log_unif = -log(T_max);
}

parameters {
  real<lower=0> lambda_1;
  real<lower=0> lambda_2;
}

transformed parameters {
  vector[T_max] lp[T_max];// lp[t, s] = log p(tweets[t] | lambda_1, lambda_2, s)
  vector[T_max] lp_marginal;// lp[t] = log p(tweets[t] | lambda_1, lambda_2)

  for (s in 1:T_max)
    for (t in 1:T_max)
      lp[t, s] = poisson_lpmf(tweets[t] | t < s ? lambda_1 : lambda_2);

  lp_marginal = rep_vector(log_unif, T_max);
  for (s in 1:T_max)
    for (t in 1:T_max)
      lp_marginal[s] = lp_marginal[s] + lp[t, s];
}

model {
  lambda_1 ~ exponential(a);
  lambda_2 ~ exponential(b);
  target+= log_sum_exp(lp_marginal);
}
R側で上のコードをキックしてサンプリングを行います.
.model = rstan::stan_model(file = './stan/change_point.stan')

N <- 4000
tweets <- trump_tweets.count[['n']]
T_max <- length(tweets)

# 各chain 3,000の長さのサンプル(前半) を4つ作成
.fit = rstan::sampling(.model, data = list(T_max=T_max, tweets=tweets, a=0.1, b=0.1),
                       iter=N, chains=4, warmup=1000)

rstan::stan_trace(.fit, c('lambda_1', 'lambda_2'))

rstan::stan_hist(.fit, pars = c('lambda_1', 'lambda_2'))

.fit %>%
    rstan::extract(pars = c('lambda_1', 'lambda_2')) %>%
    lapply(summary)
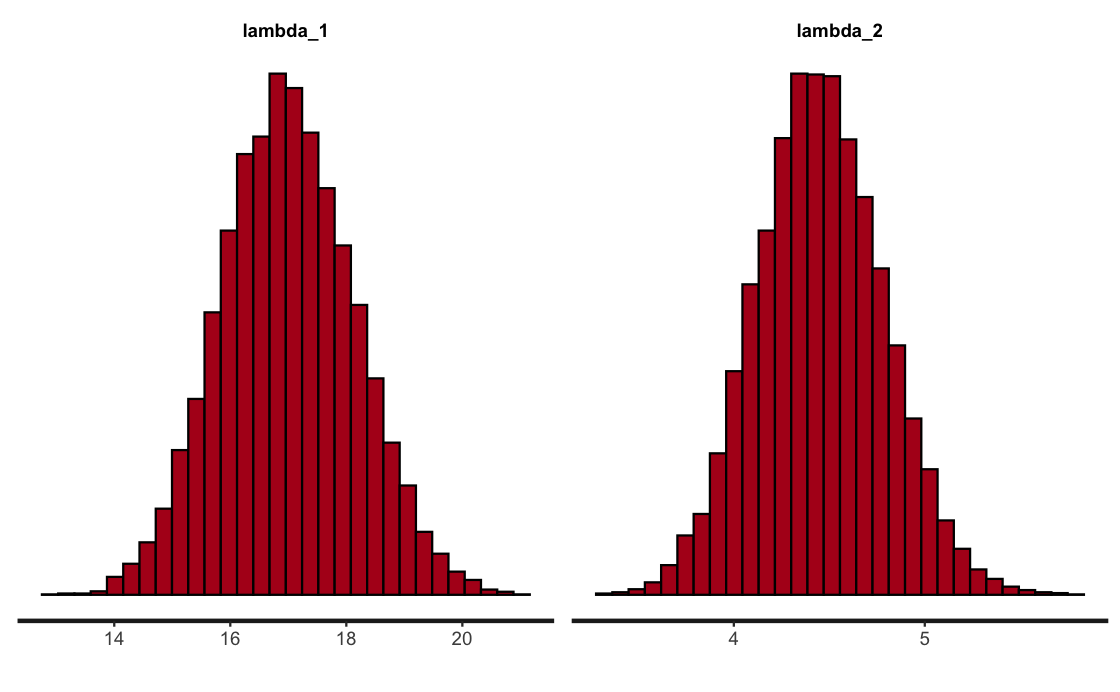
中央値では, と推定されました.
特に, 変化点の前半では平均して約3.6倍多く「MAKE AMERICA GREAT AGAIN」ツイートが投稿されていたと考えられます.
変化点の事後分布とその可視化
の事後分布はMonte Carlo法を用いて次のように計算できる.
先ほどのサンプリング結果からの事後確率をR側で計算するには次のようにします,
# p(tau | tweets)
tau_post <- rep(0, T_max)

for (tau in c(1:T_max)) {
  tau_post[tau] <- .fit %>%
    rstan::extract(pars = str_glue('lp[{c(1:T_max)}, {tau}]')) %>%
    as_tibble() %>%
    apply(MARGIN = 1, function(y) exp(sum(y))) %>%
    mean
}

tau_post <- tau_post / sum(tau_post)

tau_post.df <- data.frame(date_to_month = trump_tweets.count$date_to_month, prob = tau_post)

tau_post.df %>%
  ggplot(aes(x=date_to_month, y=prob, label=if_else(prob > 0.1, date_to_month, NULL))) +
  geom_col() +
  geom_text(vjust = 0, nudge_y = 0.05) +
  ylab('posterior probability of tau') +
  ggtitle('posterior probability of tau')
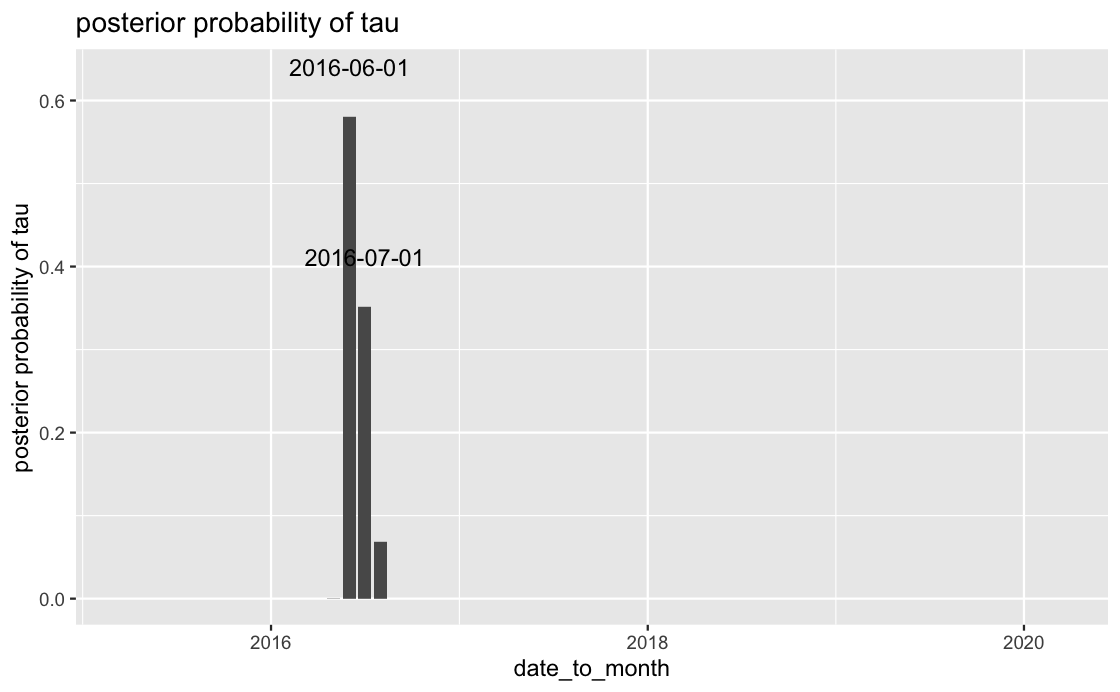
変化点の事後確率のピークは2016年6月ということがみて取れます. 2016年7月に開かれた共和党全国大会の時期にかけて、 集中的に「MAKE AMERICA GREAT AGAIN」と呟いていたということがわかります.
